
AI 生图工具怎么选?从模型能力到设计场景
“帮我生成一张高级、有设计感的产品海报。”
“帮我生成一张高级、有设计感的产品海报。”
同样一句提示词,丢给不同的 AI,结果可能差很多。
有的更擅长写实质感和复杂光影,有的图中文字更稳定,有的适合拿参考图继续修改,还有的第一张效果很惊艳,但很难稳定地生成第二张、第三张。
所以设计师刚开始接触 AI 生图时,很容易陷入一个问题:
到底哪个 AI 生图最好?
但真正进入项目以后,你会发现,最终效果通常不只由“模型强不强”决定,而是这几个环节一起作用:
- 模型能力:决定它大致能做到什么,包括提示词理解、画面质量、文字表现、参考图理解和编辑能力
- 平台能力:决定你怎么使用这些能力,比如能不能上传参考图、局部修改、扩图、切换模型和管理素材
- 输入材料:提示词、参考图、品牌色、产品素材和构图要求,决定生成方向准不准
- 后期处理:筛选结果、修正细节、重新排版和适配尺寸,决定它最后能不能真的进入项目
所以挑工具的时候,与其一直问:“哪个 AI 生图最强?”
不如先想清楚:我到底要生成什么?
快速找视觉灵感、做一张品牌海报、连续生成十几张 Campaign 素材、修改现有产品图,甚至从视觉生成延展到网页和视频,对工具的要求都不一样。
先看任务,再选模型和平台,比追着“最强生图工具”更有用。
一、模型和平台不是一回事
选生图工具之前,先简单分清两个概念。
模型决定生成能力的大致上限,平台决定普通用户怎样使用这些能力。
比如 Seedream 是图像模型,当它被集成到具体产品里之后,我们才能通过网页或 App 上传参考图、生成图片、继续修改和导出结果。
同一个模型可能出现在多个平台里,一个平台也可能同时接入好几个模型。
所以:
- 想看目前 AI 生图能力能做到什么,看模型
- 想知道自己实际干活顺不顺手,看平台
所以下文会同时提到模型和平台,因为设计师真正工作时,最终打开使用的通常还是具体产品。
二、目前值得关注的生图模型有哪些?
“最强模型”这件事,现在很难只给一个名字就完事了。
因为 AI 图片其实包含很多不同能力:
从零生图、图片编辑、图中文字、多图融合、人物一致性、产品一致性、复杂构图、参考图理解……
一个模型文生图很强,不代表改图也一定最好;一个模型第一张图很惊艳,也不代表它适合连续做一整套视觉。
所以榜单更适合用来观察目前哪些模型处于头部,而不是直接当成一张永久有效的“战力表”。
根据本文整理时的 2026 年 9 月 Arena 榜单,目前比较值得设计师关注的主要有以下几条路线:
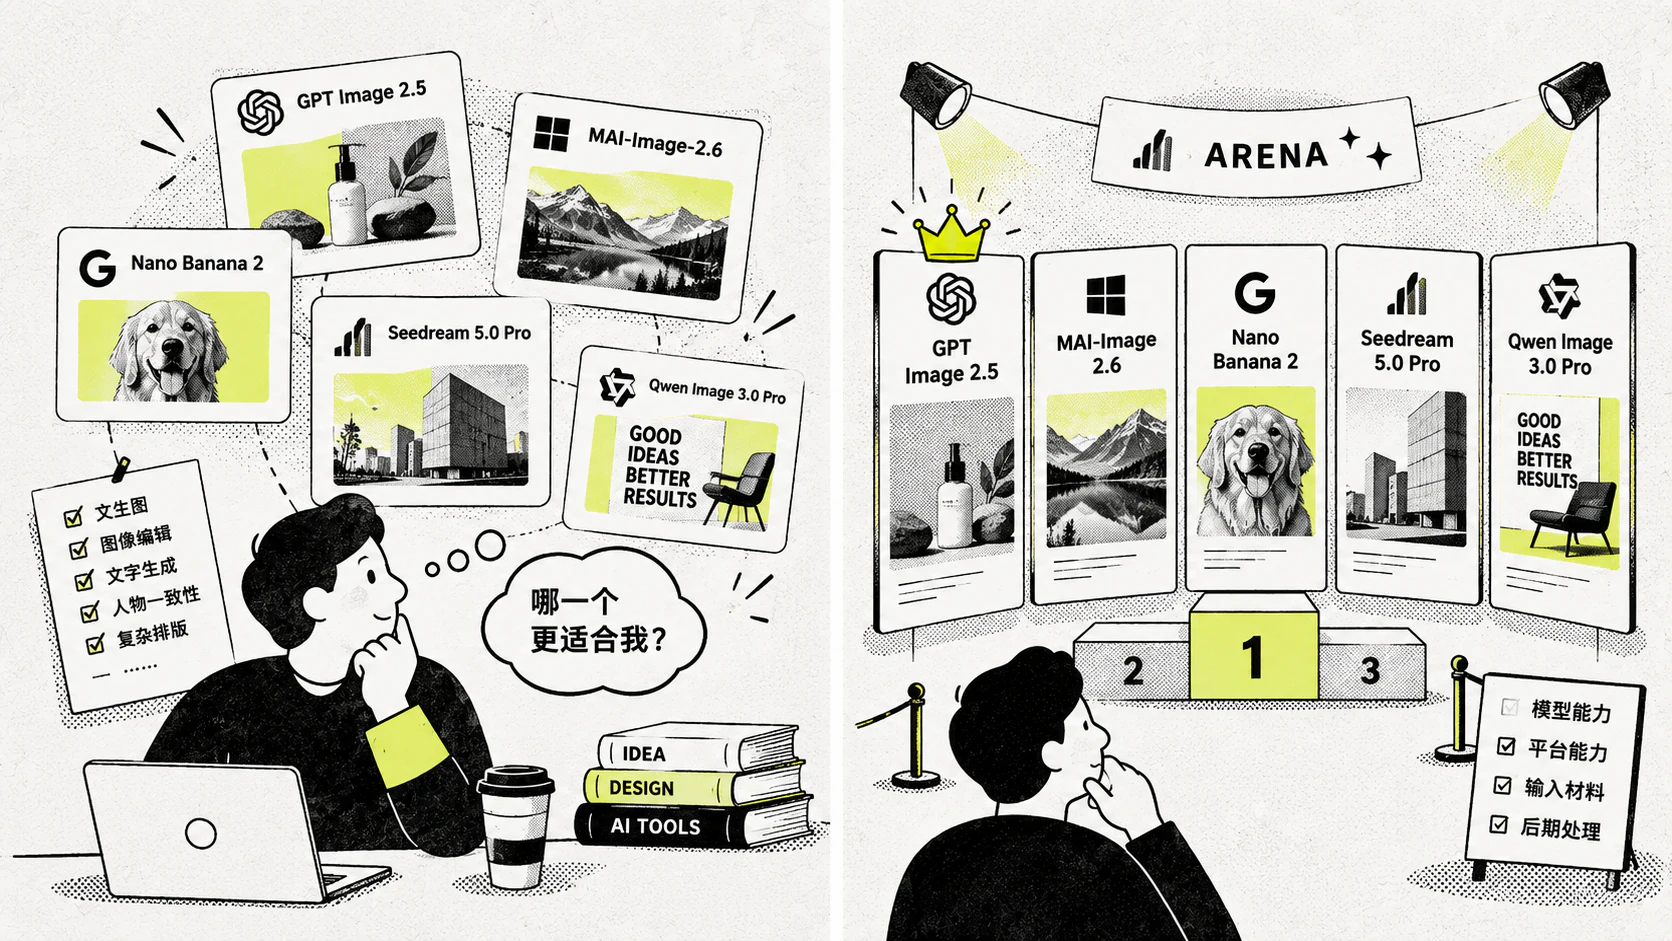
(注:Arena 可以理解成 AI 模型的“公开擂台赛”:同一个任务让不同模型来做,用户不知道谁是谁,只看结果投票,最后根据大量真实用户的选择排出榜单。)
GPT Image 2.5
Arena 表现:Sunburst 文生图第 1、单图编辑第 1、文字生成第 1,目前均为 Preliminary
最擅长:复杂指令、图中文字、海报和商业视觉、精准改图、连续多轮修改
主要入口:ChatGPT Images;API 中为 GPT-Image-2.5 Flare / Sunburst
MAI-Image-2.6
Arena 表现:文生图第 4、单图编辑第 5,目前属于第一梯队
最擅长:写实视觉、商业图片、多图参考、文字生成、基于网络资料生成视觉
主要入口:MAI Playground、Microsoft Foundry
Nano Banana 2
Arena 表现:文生图第 9、单图编辑第 12、文字生成第 9
最擅长:多图理解、人物和物体一致性、知识图解、信息图、结合真实世界知识生成图片
主要入口:Gemini、Google AI Studio
Seedream 5.0 Pro
Arena 表现:文生图第 10、单图编辑第 8
最擅长:商业视觉、复杂构图、信息可视化、写实影像、多图编辑
主要入口:字节系产品与 API 服务
Qwen Image 3.0 Pro
Arena 表现:文生图第 11,目前已经进入综合榜单前列
最擅长:中文和多语言文字、复杂版式、信息图、网页和界面类视觉、多图编辑
主要入口:千问、QwenCloud、阿里云百炼等阿里系平台
这里尤其要注意:Arena 里一些刚上线的模型会标注 Preliminary,表示测试数据还不够充分,后面的排名可能继续变化。所以真正做设计的时候,排名只能帮你缩小范围。
最终还是要回到:我这一轮最需要它解决什么问题?
三、不同设计场景下,怎么选择工具?
前面看的是模型。但真正工作时,我们一般不会一直研究模型名称,而是直接打开 ChatGPT、Gemini、即梦、Midjourney、Recraft、Higgsfield 这些产品。
下面按照设计师比较常见的工作场景来选。
场景 1:UI、产品原型和网页设计
适合任务
App、Dashboard、后台系统、Web 产品、交互原型、官网
主推
ChatGPT、Figma Make、Framer
严格来说,这一类已经不只是“生图”。过去 AI 做 UI,更多是生成一张看起来像网页或 App 的图片;现在越来越多工具可以直接生成可编辑、可点击甚至可以运行的页面。
所以如果你的最终目标本来就是 UI,不一定要停在“生成一张界面图”。
怎么选
- ChatGPT:适合先梳理需求、页面结构、交互逻辑和视觉方向,也可以生成 UI 视觉参考
- Figma Make:适合已经在 Figma 工作流里的设计师,把现有设计、组件和 Design System 继续做成交互原型
- Framer:更适合官网、Landing Page 和作品集,从页面设计继续做到发布
如果已经进入正式代码项目,再使用 Codex、Claude Code、Cursor 等 Coding Agent 会更合适。
典型工作流举例
比如做一个 SaaS Dashboard:
需求和页面结构梳理
→ 确定视觉参考
→ Figma 建立核心 Design System
→ AI 生成或搭建页面
→ 做成可以实际操作的 Demo
→ 根据真实运行结果继续修改
需要注意
“生成一张 UI 图片”和“完成一个可以使用的 UI”不是一回事。
如果只是找方向,图片生成已经够用。
如果需要真实交互、响应式、组件状态和开发交付,就应该继续进入 Figma、Framer 或 Coding 工具。
场景 2:网站主视觉、品牌调性图和概念视觉
适合任务
官网 Hero、品牌 KV、Moodboard、概念视觉、产品场景图、视觉探索
主推
ChatGPT、Midjourney、Gemini、Recraft、即梦 AI
这类任务主要解决的是视觉方向和素材探索。
怎么选
- ChatGPT:适合只有一个模糊想法,希望通过对话慢慢确定构图、材质、摄影方式和视觉方向。
- Gemini(Nano Banana 2):适合已经有人物、产品、服装、环境等多张参考图,需要把它们组合到一个画面里。
- Midjourney:适合大量探索不同风格和审美方向。
- Recraft:更偏品牌、平面、插画、矢量和系列化视觉,对设计师比较友好。
- 即梦 AI:国内使用方便,适合人物、产品和商业视觉探索。
典型工作流举例
比如设计一个香氛品牌官网:
收集参考图和品牌关键词
→ ChatGPT / Midjourney 探索视觉方向
→ Gemini 组合产品、花卉和材质参考
→ 回到 Figma / Photoshop 完成正式设计
需要注意
AI 更适合前期找方向和生成素材。
真正进入品牌和网页设计后,Logo、字体、栅格、版式和品牌规范还是需要回到专业设计软件处理。
场景 3:中文海报、信息图和知识配图
适合任务
中文海报、知识图解、信息图、教程配图、简单图表
主推
ChatGPT、Gemini、千问、即梦 AI
对应到前面介绍过的模型,大致是:
ChatGPT → ChatGPT Images 2.5 Gemini → Nano Banana 2 千问 → Qwen Image 3.0 Pro 即梦 AI → Seedream 系列
这一代模型已经开始能处理标题、正文、标注和比较复杂的信息层级。
怎么选
- ChatGPT:适合复杂指令、中文文字、图文结合和反复修改。
- Gemini:适合先理解资料,再把内容整理成视觉图解。
- 千问:适合中文、多文字和复杂信息类图片。
- 即梦 AI:适合中文环境下的商业视觉和快速生成。
典型工作流举例
比如给一篇 AI 教程做知识图解:
把文章内容交给 AI
→ 提炼信息层级
→ 生成第一版信息图
→ 检查文字和结构
→ 回到 Figma / Photoshop 精修
需要注意
AI 生成的是一张“像设计稿”的图片,不是真正可编辑的设计文件。
正式使用前还是需要检查文案、错别字、字体、字号、对齐、品牌规范和输出尺寸。
场景 4:小红书、公众号和日常运营物料
适合任务
小红书封面、公众号配图、活动海报、Banner、日常营销素材
主推
Canva 可画、稿定设计、美图设计室、Figma
这类任务最看重的是后续修改效率。
标题、价格、日期、产品图和尺寸经常都会反复变化,所以编辑型工具通常比单纯生图更实用。
怎么选
- Canva 可画:适合模板化运营内容和多尺寸适配。
- 稿定设计:适合国内电商、营销和运营物料。
- 美图设计室:适合图片处理、商品和营销素材。
- Figma:适合有固定品牌规范、需要长期维护视觉系统的团队。
常见工作流举例
ChatGPT / Gemini / Midjourney / 即梦生成主视觉
→ Canva / Figma / Photoshop 完成排版
→ 批量适配小红书、公众号、Banner 等不同尺寸
需要注意
日常运营不一定需要最强的生图模型,更重要的是方便改、方便复用、方便批量适配。
场景 5:品牌 Campaign、社交媒体和成套视觉
适合任务
Campaign KV、系列海报、社交媒体、Banner、产品图、短视频
主推
TapNow、Recraft、Lovart
当需求从“一张图”变成“一整套视觉”,判断标准就发生了变化。
这个时候除了单张效果,还要考虑:
- 风格能不能统一
- 产品能不能保持一致
- 人物能不能连续出现
- 同一个视觉方向能不能延展十几张
- 图片、视频和不同尺寸之间能不能继续复用
怎么选
- TapNow:适合图片、视频、音频和多个模型一起使用,可以通过节点式 Canvas 把流程串起来。
- Recraft:更偏平面和品牌设计,适合插画、矢量、系列视觉和统一风格资产。
- Lovart:适合把 Brief 和参考图交给 AI,快速尝试不同 Campaign 方向,再延展成多种营销物料。
典型工作流举例
比如做一个新品 Campaign:
上传产品素材
→ 生成主 KV
→ 延展社交媒体视觉
→ 生成 Banner
→ 继续生成短视频
需要注意
这类平台可以明显提高探索和视觉延展效率。
但真正严格的 Brand Guideline、精准版式和最终商业交付,依然需要设计师继续把关。
场景 6:电商商品图、模特图和详情页
适合任务
商品主图、场景图、AI 模特、试衣、详情页、A+、批量商品素材
主推
国内:美图设计室、稿定设计
海外:Photoroom
电商场景最重要的是商品准确度、批量处理和后续编辑。
怎么选
- 美图设计室:适合商品图、AI 模特、试衣、商品场景和带货素材。
- 稿定设计:适合主图、商品精修、场景图、模特试衣、详情页、多语言和多尺寸。
- Photoroom:更适合 Shopify、Amazon 和海外独立站,重点围绕真实商品生成背景、模特和营销图片。
典型工作流举例
比如给一双鞋做电商素材:
上传真实产品图
→ AI 去背景
→ 更换不同场景
→ 加入 AI 模特
→ 批量生成不同尺寸
→ 制作详情页
需要注意
只要产品形状、Logo 和包装文字必须准确,就尽量保留真实商品素材,让 AI 主要负责背景、环境、人物和氛围。
场景 7:分镜、TVC 和 AI 视频
很多设计师现在已经不只做静态图片,探索 AI 视频、商业广告的不在少数。
这时候图片生成通常只是第一步。
适合任务
Storyboard、广告分镜、TVC、MV、产品短片、多镜头视觉
可以了解
Runway、LibTV、Higgsfield、TapNow
这些工具解决的重点已经从:“生成一张图”
逐渐变成:把人物、场景和关键帧继续组织成连续镜头。
一个比较常见的流程是:
脚本
→ 人物和场景设定
→ 生成关键帧
→ Storyboard
→ 图片转视频 / 文生视频
→ 多镜头生成
→ 剪辑和声音
所以如果你只是偶尔让一张海报动起来,不需要马上学习完整的视频工作流。
但如果未来想进入广告、短片或 AI Video,这类平台值得提前知道。
总而言之,没有一个工具能包办所有视觉任务。
真正要看的,不是它“是不是最强”,而是它能不能在你的具体任务里稳定生成、顺利修改,并最终交付合格的结果。
这才是选择 AI 生图工具更重要的判断标准。
本文更新于 2026 年 9 月 9 日。模型表现主要参考 Arena Text-to-Image / Image Edit 公共榜单。Arena 采用用户盲测投票,可以帮助观察模型能力变化,但榜单会持续更新,新模型还可能标记为 Preliminary,因此本文不把某一天的排名直接等同于“最好用”。产品功能主要通过 OpenAI、Google DeepMind、ByteDance Seed、Alibaba Cloud、Midjourney、Ideogram、Recraft、Lovart、TapNow、Higgsfield、LibTV、Runway 等官方资料核对。厂商披露的用户量、生成量与第三方 MAU 不是同一口径,不做直接比较